LLM
Transformer
1.模型架构
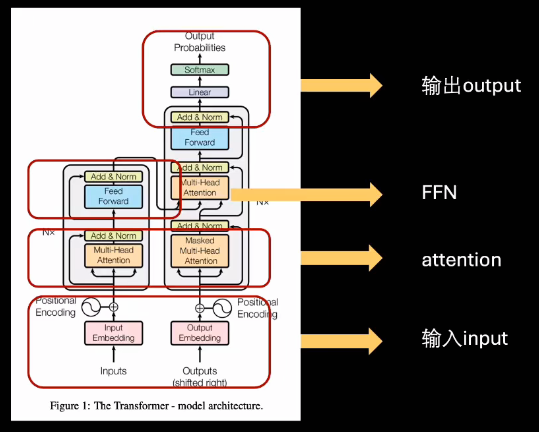 现有的架构:
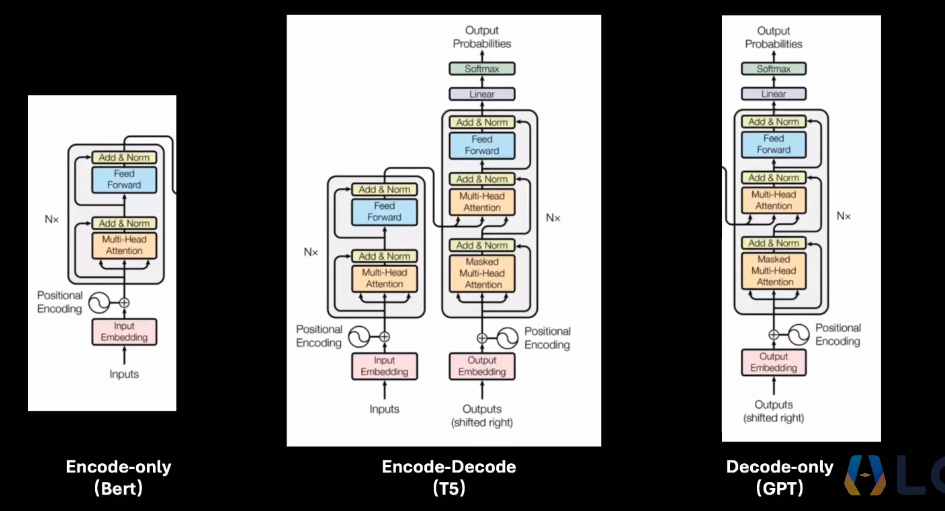 encode-only:特征提取,如bert,能够比较好地理解语义,常用于做舆情分析,判断两句话之间的关系和联系的强弱
encode-decode:机器翻译,交叉注意力机制(只在encode-decode架构中)
decode-only:自回归架构
2.embedding 首先我们需要想办法让计算机理解自然语言,通过分词器,用词向量来表示一句话中的每个词 可以用一个数字来表示某个词,但是这样丢失了词之间的关系; 为了表示每个词之间的关系,采用 one-hot 编码(稀疏矩阵)来捕捉单词之间的关系; 但是这个方式也不够好,于是采用了稠密向量的方式,这样能够通过向量之间的距离来表示词之间的关系。维度的多少和语义大小有关,现在常用4096/8192维
3.attention
目标词所受的影响来源于:上下文中别的词,句子中词的位置
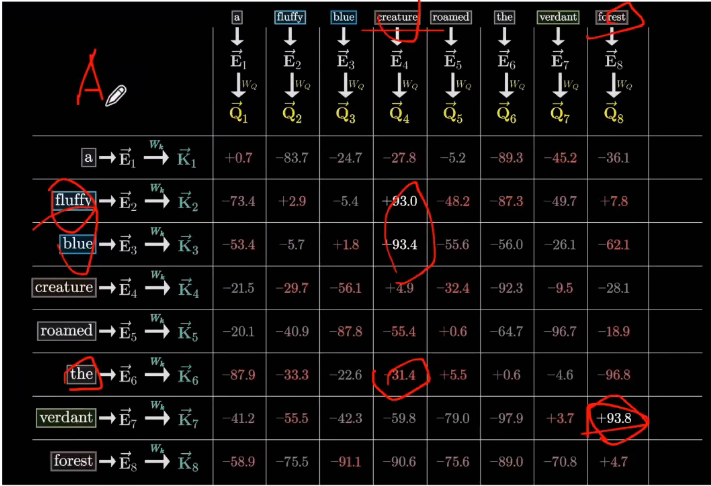
注意力机制就是看别的单词在这句话里面对自己的影响是什么
注意力矩阵:由Q和K相乘得到,其中的数值是指某个词对另一个词的影响,数值越大则影响越大
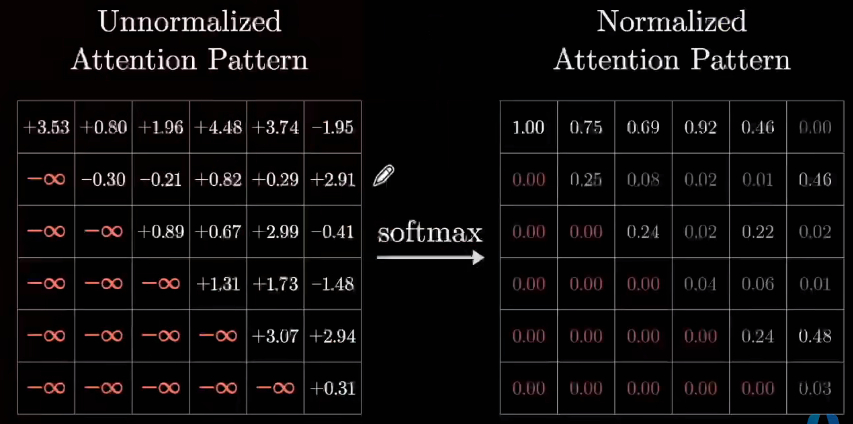
 用softmax来让注意力(影响向量)的系数加和为1,且取值在0-1之间
只根据前文的内容来确定目标词是什么,需要一个mask矩阵来把后面单词对前面单词的影响给遮蔽掉
 attention矩阵决定影响的方向,value决定偏移的大小,通过attention矩阵和V相乘得到这个偏移数值
最后结合自身语义和其他语义的影响,最终得到了在句子中的语义,这个过程就是残差链接的过程,残差链接也用于防止梯度爆炸和梯度消失问题,如果attention对本次迭代没有收益,就忽略掉这次计算
完整过程:
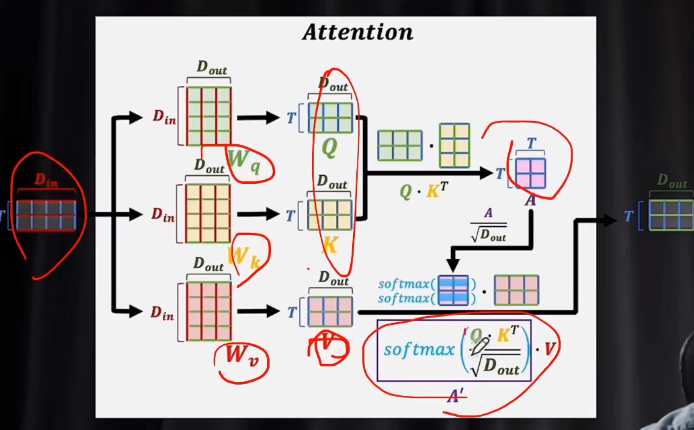
4.多头注意力机制MHA 多用几个Wq、Wk、Wv矩阵来和input矩阵相乘,得到多个Q,K,V矩阵 再经过layer norm 多头注意力矩阵算出来的结果直接相加,不同的头学习不同的信息,如果整体去学,可能整体效果不好,分头去学可以降低效果不好的头所带来的影响
5.交叉注意力机制 用于结合encoder的output和decoder的input,decoder的Q去查encoder的K,V,注意力矩阵的维度就是sequence的维度 gpt没有交叉注意力,只有自注意力
6.代码逻辑 分词器tokenizer - 词向量嵌入embedding - 位置编码(分为绝对/相对/旋转),position embedding和input embedding是等维的