第一章 agent简介
一、Agent简介
1.什么是agent? agent是一个系统,它通过llm与环境交互,以实现用户定义的目标。它结合推理、规划和调用外部工具执行来完成任务。
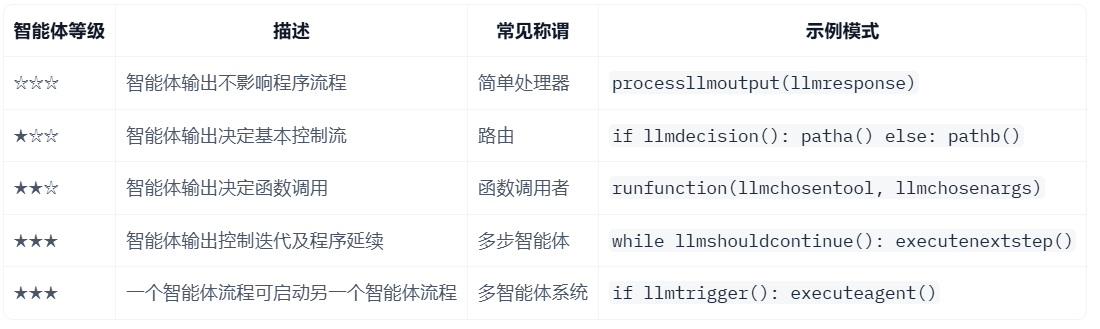
2.agent的能力层级
3.agent的架构 llm是大脑,tools是身体 actions和tools是不同的概念,一个action可能涉及多个tools
二、LLM基础
1.LLM LLM是一种擅长理解和生成人类语言的AI模型。 LLM的目标是在给定一系列前一个token的情况下,预测下一个token。 大模型是自回归的,一次通过的输出成为下一次的输入。这个循环持续执行,直到模型预测下一个token为EOS(结束符)token,模型停止。
单个解码循环中发生的事情:
- 文本被tokenized后,模型会计算序列的表示,该表示包含输入序列中每个token的意义和位置信息
- 这个表示被输入到模型中,模型输出分数,这些分数对词汇表中的每个token作为序列中的下一个token的可能性进行排名
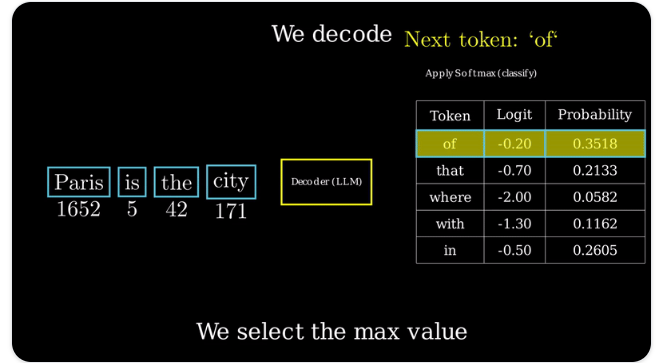 基于这些分数,有多种策略来选择token以完成句子
- 最简单的解码策略是总是选择分数最高的token
- 束搜索会探索多个候选序列,来找到总分数最高的序列,即使其中一些单个token的分数较低
2.transformer
大多数LLM都是基于transformer架构构建的
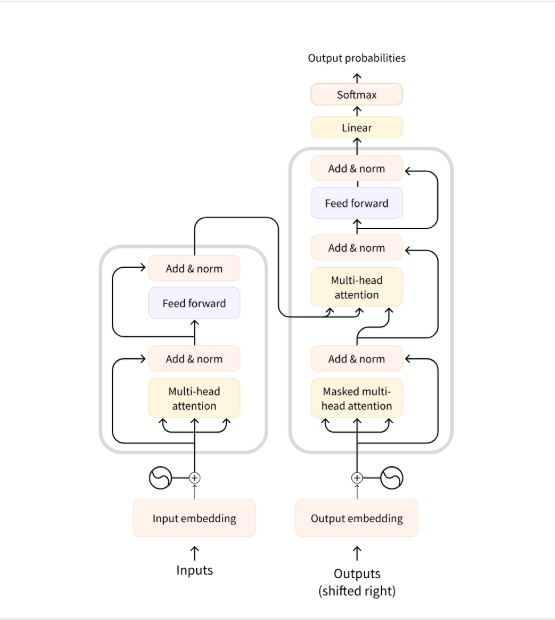 transformer的类型:
- 编码器:基于编码器的transfomer接收文本作为输入,并输出该文本的密集表示或嵌入。如bert,用于文本分类、语义搜索和命名实体识别。一般是几百万个参数。
- 解码器:基于解码器的transformer专注于逐个生成token以完成序列。如llama,用于文本生成、chatbot、代码生成。一般是数十亿个参数。
- 序列到序列:结合了编码器和解码器,编码器首先将输入序列处理成上下文表示,然后解码器生成输出序列。如T5和BART,用于翻译、摘要、改写。一般是数百万个参数。
3.注意力机制attention 在预测下一个词的时候,句子中的每个词并不是同等重要的。通常识别最相关的词来预测下一个token。 context window是指llm能够处理的最大token数,以及最大的attention跨度
4.prompt llm唯一的工作是通过查看每个输入token来预测下一个token,并选择哪些token是重要的,因此prompt非常重要。
5.llm training llm是在大型文本数据集上进行训练的,通过子监督或者掩码语言建模目标来学习预测序列中的下一个词。 这是一种无监督学习,模型能够学习语言的结构以及文本中的潜在模式,使模型能够泛化到未见过的数据。 在初始的预训练之后,llm可以在监督学习目标上进行微调,以执行特定任务。
三、Messages and Special Tokens
1.聊天模板 聊天模板充当对话消息与所选llm的特定格式要求之间的桥梁,确保每个模型都能接收到正确的格式化propmt 特殊tokens是模型用来界定用户和助手轮次开始和结束的标记
- 基础模型是在原始文本数据上训练来预测下一个token的模型
- 指令模型是专门微调以遵循指令并进行对话的模型 聊天模板的作用是:以模型能够理解的一致方式格式化我们的提示,这样能够让基础模型变得更像指令模型。ChatML是一种模板格式。 llm通过聊天模板构建输入,使用工具是做这件事的主要方式之一
2.消息 消息是llm的底层系统 系统消息定义了模型应该如何表现,是持久性指令,指导后续交互。 系统消息会提供有关可用工具的信息,为模型提供如何格式化要采取的行动的指令,并包括关于思考过程如何分段的指南。
3.对话 对话由用户和llm之间的交替消息形成 聊天模板通过保存对话历史记录,存储用户和llm之间的前序交流来维持上下文。
四、工具
1.AI工具的定义 工具是赋予LLM的函数,并且有一个明确的目标,作用是补充LLM的能力。 LLM基于训练数据预测提示的补全,其内部知识仅包含训练截止前的信息。如果Agent需要获取最新数据,则需要通过工具 工具应该包含:
- 函数功能的文本描述
- 可调用对象,即执行操作的实体
- 带类型声明的参数
- 带类型声明的输出(optional)
2.为LLM提供工具 LLM 只能接收文本输入并生成文本输出,无法自行调用工具。给agent提供工具实际上是让llm认识到工具的存在,并要求模型在需要的时候生成调用工具的文本。 核心是通过system prompt项模型文本化描述可用工具,需要精准描述工具功能和预期输入格式。 工具描述通常采用结构化表达方式,如JSON
3.MCP模型上下文协议 MCP作为统一的工具接口,是一种开放式协议,规范了应用程序向LLM提工具的方式。 MCP提供:
- 不断增加的预构建集成列表,LLM可以直接接入这些集成
- 在LLM提供商和供应商之间灵活切换的能力
- 在基础设施内保护数据安全的最佳实践 任何实施MCP的框架都可以利用协议中定义的工具,从而无需为每个框架重新实现相同的工具接口
五、通过思考-行动-观察循环理解 AI Agent
1.核心组件 Agent的持续循环:思考-行动-观察
- 思考:LLM部分决定下一步干什么
- 行动:Agent通过参数调用工具来行动
- 观察:LLM对工具的相应进行反思
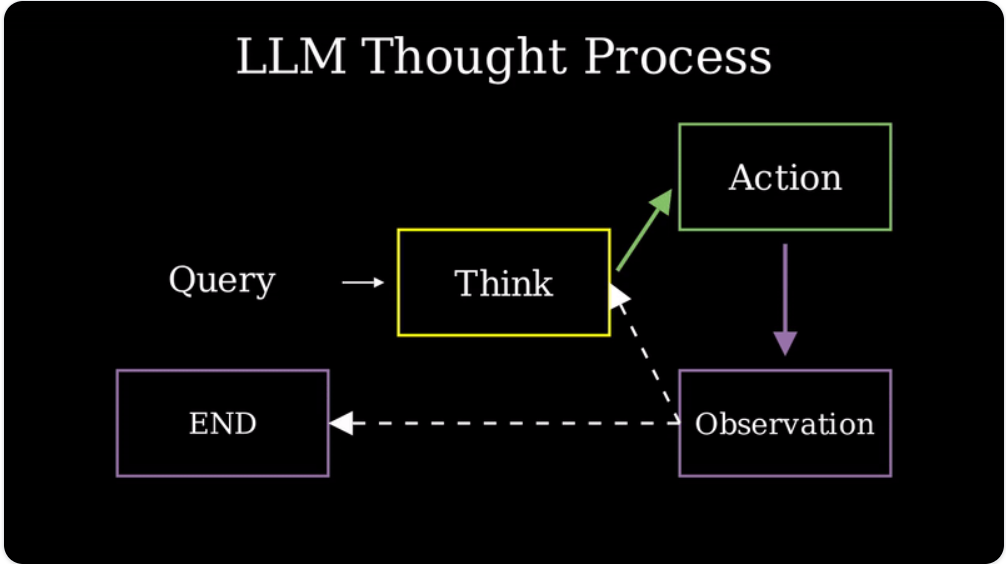 在许多Agent框架中,规则和指南直接嵌入到系统提示中。
智能体在目标实现之前不断迭代循环。
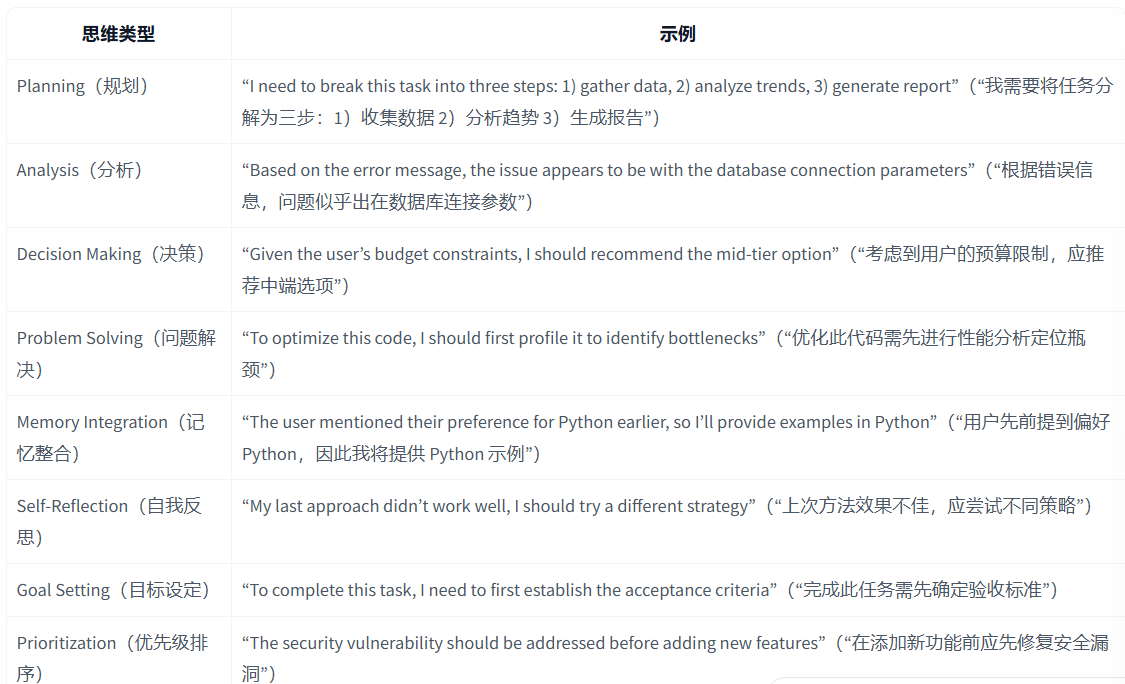
2.思维机制-thought
思维代表Agent解决任务的内部推理和规划过程,利用了Agent的LLM能力来分析其prompt中的信息。
通过这个过程,Agent能够把复杂问题分解为更小、更易管理的步骤。
常见思维模式:
3.ReAct 方法
ReAct 方法是核心方法,即推理和行动的结合。
ReAct是一种提示技术,让LLM解码后续token前添加“让我们逐步思考”的提示。
通过提示模型逐步思考,引导解码过程生成计划而非直接输出最终解决方案,让模型倾向于把问题分解成子问题。
常见的推理策略:模型经过微调,被训练为”先思考再回答”。通过特殊标记(<thought> 和 </thought>)来界定思考部分。
4.动作-Action
动作是AI Agent与其环境交互的具体步骤
不同Agent采用的不同动作执行方式
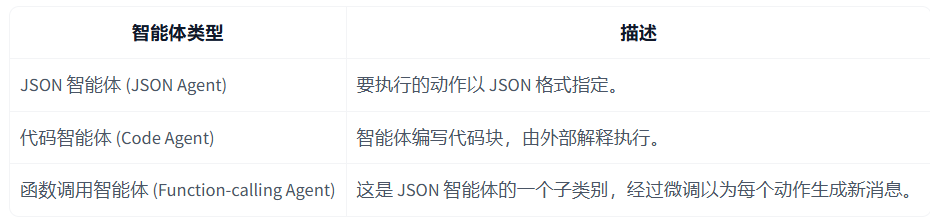 Agent在动作完成时能够停止生成新的tokens,这样能够防止意外输出并确保智能体的响应清晰准确。
5.停止和解析方法 停止和解析方法是实现动作的一个关键方法,这种方法确保Agent的输出具有结构性和可预测性。
- 以结构化格式生成:Agent以清晰、预定义的格式(JSON或代码)输出其预期动作。
- 停止进一步生成:一旦动作完成,智能体停止生成额外的标记。这可以防止额外或错误的输出。
- 解析输出:外部解析器读取格式化的动作,确定要调用哪个工具,并提取所需的参数。
6.代码智能体 代码智能体是实现动作的另一个方法,代码智能体不是输出简单的JSON对象,而是生成一个可执行的代码块——通常使用python等高级语言。 这种方法的优势在于:
- 表达能力:代码可以自然地表示复杂的逻辑,包括循环、条件和嵌套函数,提供比 JSON 更大的灵活性。
- 模块化和可用性:生成的代码可以包含在不同动作或任务中可重用的函数和模块
- 更强的可调试性:使用明确定义的编程语法,代码错误通常更容易检测和纠正
- 直接集成:代码智能体可以直接与外部库和API集成,实现更复杂的操作,如数据处理或实时决策。 这种方法也遵循停止和解析方法
7.观察-Observation 观察是Agent感知其行动结果的方式,提供关键信息,为Agent的思考过程提供燃料并指导未来行动。 来自环境的信号,如API返回的数据、错误信息和系统日志,都指导着下一轮的思考循环。 观察阶段的Agent:
- 收集反馈:接收数据或确认其行动是否成功
- 附加结果:将新信息整合到现有上下文中,有效更新记忆
- 调整策略:使用更新后的上下文来优化后续思考和行动 这种迭代式反馈整合确保Agent始终保持与目标的动态对齐,根据现实结果不断学习和调整。
8.结果如何被附加? 执行操作后,框架(即Agent Framework/Runtime)进行以下处理:
- 解析操作:识别要调用的函数和使用的参数
- 执行操作
- 结果附加:将结果作为observation附加到context