Agent basics
1.agent能力与构建
- 准确进行工具调用
- harness:语法约束解码
- LLM:通过SFT在tool-calling traces上训练
- 长上下文的一致性
- harness:压缩context,动态记忆查询,subagents
- LLM:通过SFT在长上下文上训练
- 可自定义
- harness:agent memory,skills,自定义工具
- LLM:通过RL学习用户反馈
- 复杂任务管理
- harness:提供plan工具/模式(可能通过纯prompt实现),subagents
- LLM:通过RL在复杂、长程任务上训练
- 环境理解
- harness:提供对应领域的skills
- LLM:使用符合预期观测形态的数据来训练,在领域特定的环境中训练
- 安全性
- harness:沙箱,限制访问凭据,监控工作
- LLM:安全感知强化学习 构建这些能力有两种方式:LLM训练和harness工程 LLM训练:预训练,SFT(监督微调)或强化学习来改变模型行为。这样可以教会模型可复用的推理模式、工具使用和错误恢复。 harness工程:围绕LLM的系统,修改prompt、tools、memory、控制流,提供context校验,重试和safety boundaries。 能力不止来自于模型,而是LLM和harness的结合。通常遇到问题,先在harness侧进行解决,然后LLM侧会跟上,当LLM侧解决之后,harness侧就不用再专门解决了。 LLM训练可以看作一种根本解法,而harness工程则是暂时方案。 LLM训练也有解决不了的问题,如context
2.agent行为的训练过程 Pretraining-Mid-training/SFT-RL
3.harness engineering
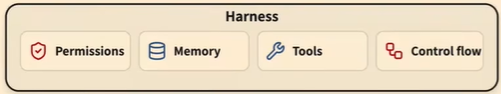
管理状态、tool、memory和控制流,验证动作、处理错误、执行权限和安全边界
 示例:
coding agent:claude code,codex,openhands,opencode,pi
orchestrators(编排器):LangChain,LangGraph,CrewAI
sandbox:
- 隔离代码和工具的执行
- 限制agent能访问的算力、网络和文件系统
- 创建可复现的环境
大模型推理:
- 提供模型生成服务
- 批处理请求,复用KV cache
- 管理数据流,并行和产出
训练系统:
- 主要是更新模型的权重,准备数据,收集rollouts
- 协调工作节点一起训练模型
- checkpoint,评估和复现运行
可观测性和监控:
- 捕捉agent工作轨迹,收集指标
- 追踪质量,成本和失败
- 比较不同的运行记录和评估结果
2.工具调用
tool use是agent最根本的能力 tool就是LLM调用外部计算机程序的一个接口,LLM自身做不到 工具的两个作用是扩展模型能力和辅助模型工作 信息检索,如RAG,搜索网络,检索信息,再基于它生成答案 代码执行,图像生成 代码可以看作一种元工具,代码的能力很强,包括表达能力、更宽的动作空间、更高的影响力等
工具调用是以token的形式表达的,如<tool_use>,工具调用的token不一定在预训练时就在词表里面,更常见的说法是在中期训练阶段引入他们,通过训练使模型适配某种特定的格式。
如果某个工具调用没有匹配的工具结果,会直接报错挂掉,会提示这是无效的历史,并且不被agent接受
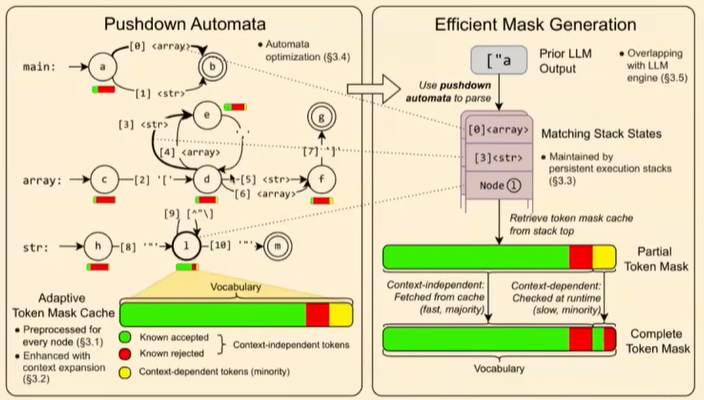
工具调用的约束,语言模型生成的工具调用不会绝对正确,我们需要设置一些约束条件。一是语法,必须是合法的JSON,这样才能被解析;二是结构,如果有预期字段或必填字段,就必须把这些都填上;三是类型,四是数值
这样做的话,就有机器可读的验证规则,可以据此检查调用是否符合schema。要表达schema是否有效,可以在其之上定义一个文法。文法如正则文法,用有限状态自动机来解析正则表达式,但是JSON无法用正则文法表达,可以用上下文无关文法,下推自动机可以解析上下文无关文法。
有些时候即使使用了约束规范,也无法生成正确的工具调用。一个例子是这样的:因为模型只能输出特定数量的token,当token用完时,可能还在自动机的合法路径上,但没走到最终状态,于是只生成了一部分JSON输出。理论上可以通过数出还剩多少可输出的token,然后提前截断。
REST API calling 工具调用除了JSON,还可以用程序代码的方式,如一个python程序,或者通过FastAPI
MCP
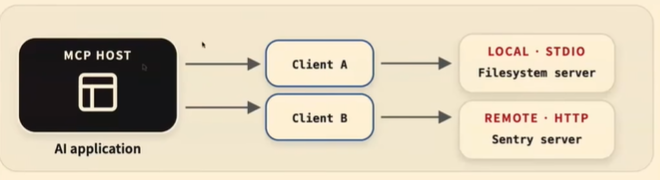
模型上下文协议,初衷是提供一种标准方式来给模型补充上下文。
MCP和直接普通调用API不一样的点在于,MCP的调用更加安全,如果你有一个github token,MCP会把token放到MCP服务器,只会给Agent一个MCP API key,让Agent自己访问服务器,这样可以避免Agent泄露github token
有个库叫FastMCP,可以理解为FastAPI版的MCP
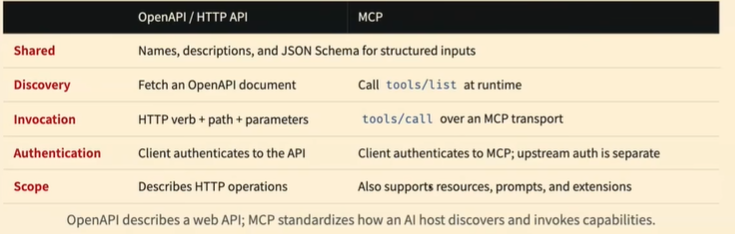
 RESTAPI和MCP的对比
Orchestrating multiple calls
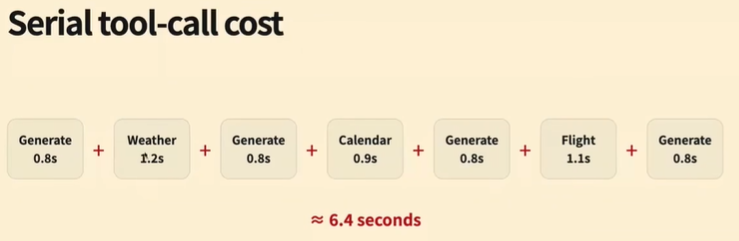
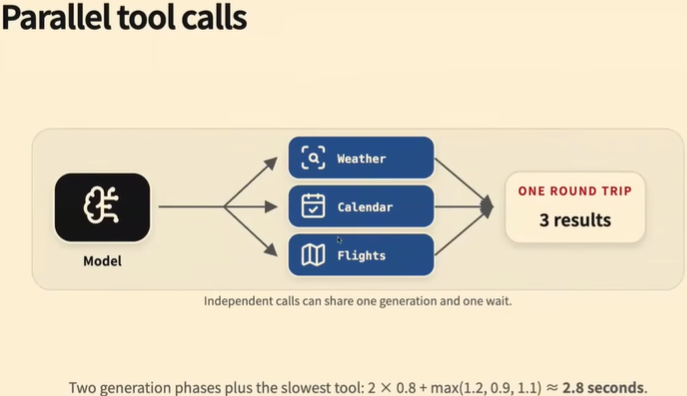
并行工具调用,工具只能一个一个地调用,导致很简单的工作也变得很长。如果这些工具互相独立,速度就会变化,做法是添加多个工具调用。
只有当工具调用之间没有依赖关系,才能够并行调用
并行工具调用是被强化学习以尽快完成任务为目标训练出来的一个Agent常用功能
Evaluating tool use 评估工具使用,评估模型选用是否合理,评估效率,工具调用错误率 即使是同一个模型,用同一个工具调用,服务商不同,最终的工具调用错误率可能也不同。原因有:
- 不同服务商的解码或推理算法可能不一样,一个很大的差别在于用不用模型量化,量化精度是多少。一般来说,FP8模型比FP4模型的工具调用错误率低得多,因为FP4压缩的太多了。
- 投机解码,可能采用了有损的投机解码,无损的投机解码应该不会影响结果
- 约束解码,约束解码算法可能不同
- 推理提供商可能不稳定
三、上下文工程
对于长上下文任务,挑战主要在于容量,也就是上下文能容纳多少内容,和效率,就是服务器能够承载多少以及相应速度
Inference-推理
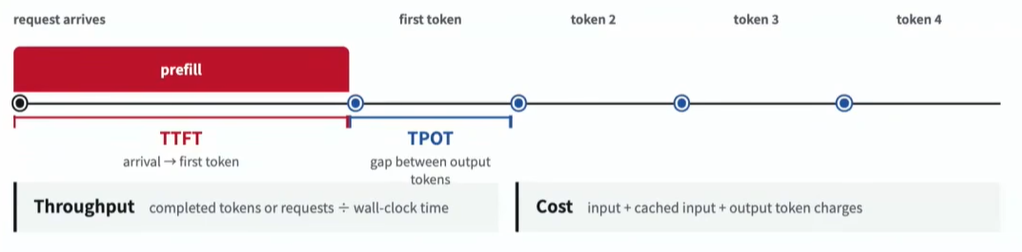
推理主要是两件事,一件事prefill(预填充),另一件事decode(解码)
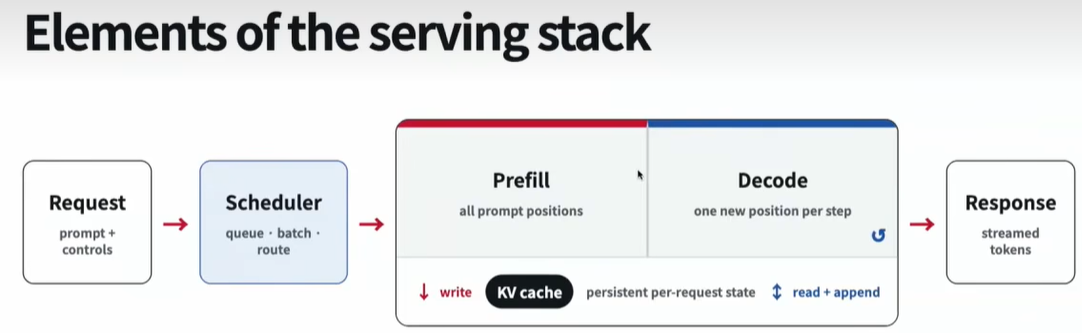 推理过程
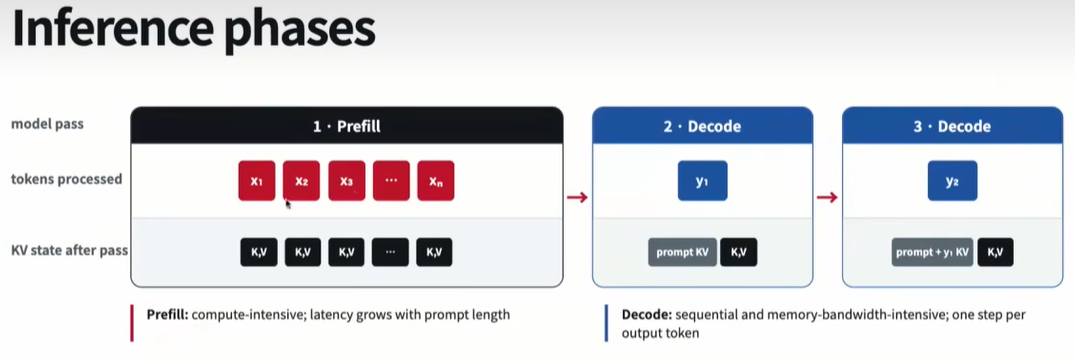 TTFT是首token时间,也就是用户给出prompt之后,到模型输出第一个token所需要的时间。
一般服务商提供的相应时间是指TPOT
 QKV计算
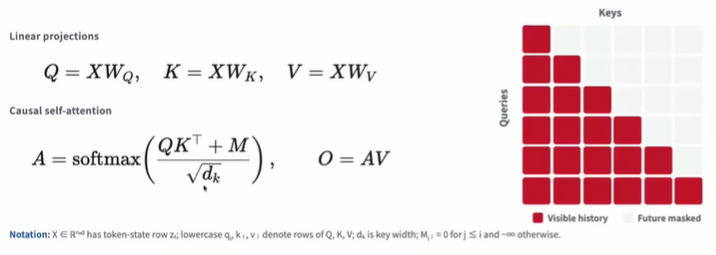 一个经典评测:旧金山最好的汉堡店
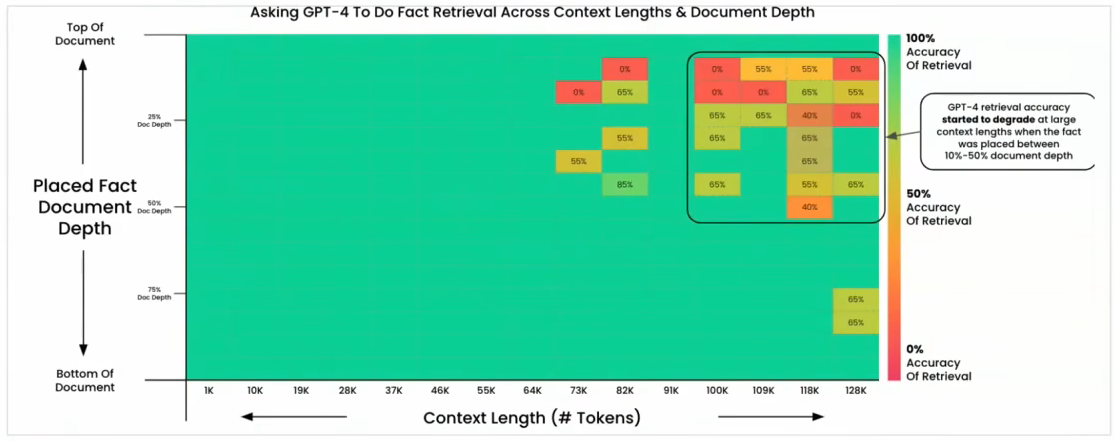 当上下文过长的时候,因为用户不断追加指令,可能会导致模型表现变差,如忘记了最初的约定或其他用户禁止的要求
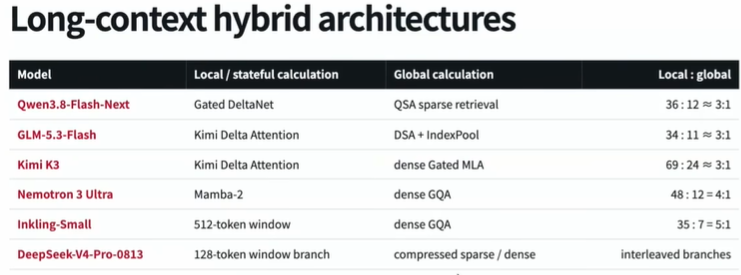
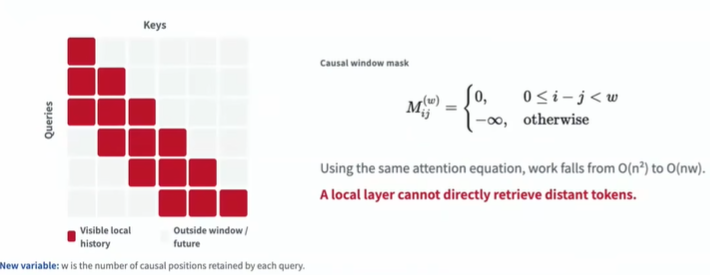
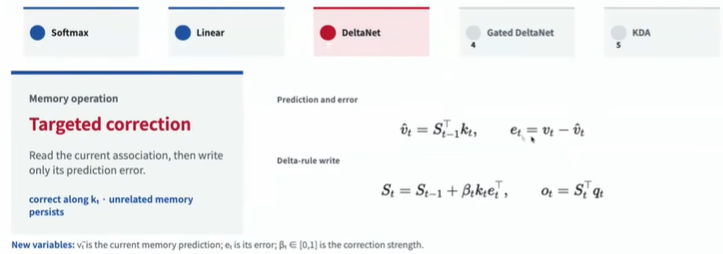
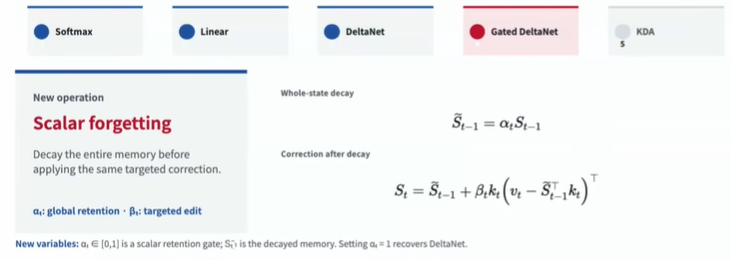
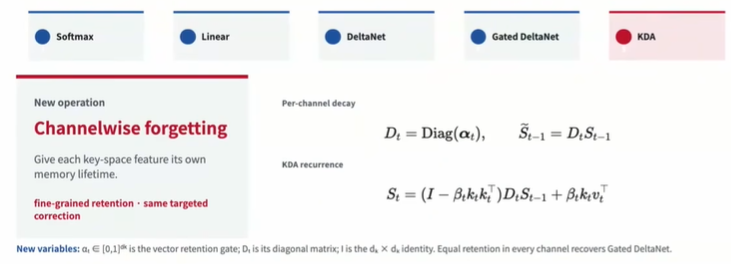
关于局部模型和全局模型,通过混合架构,让信息贯穿整个序列传递。一般做法是:混合模型,用某种局部计算,加上稀疏或稠密的全局注意力
 滑动窗口注意力,把输出分块,能够注意到当前的块和之前的块
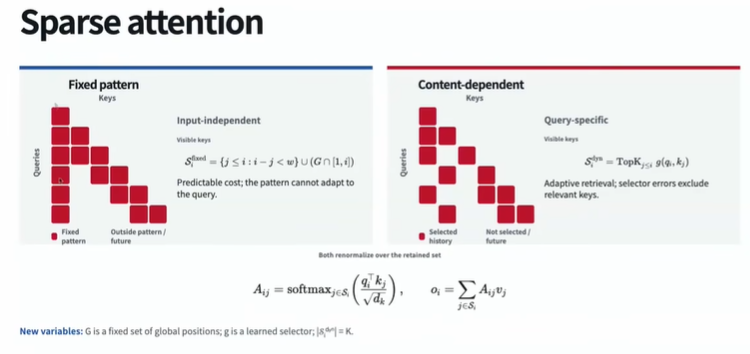
 稀疏注意力
不是去关注之前上下文里的所有内容,而是只关注其中一部分,也就是限制查找的数量
一种方式是每隔一段token就安排一次稀疏注意力,对序列长度仍然是二次的但计算量少了,比关注每个token少了很多
另一种方式是内容依赖的稀疏注意力,思路是用一种非常廉价的方式来计算注意力。如:可以把注意力向量降维投影得非常小,然后在这些非常小的注意力向量上做注意力,挑出前k个,再对这k个做完整注意力。deepseek就是这么做的。
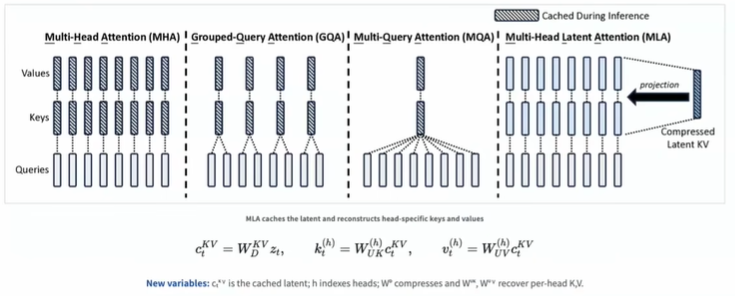
 KV compression
KV压缩
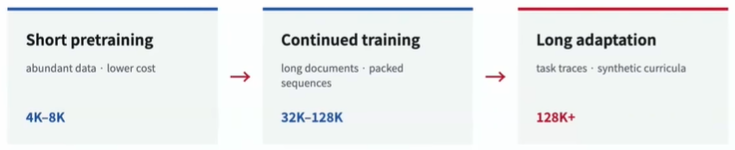
 长上下文模型的训练
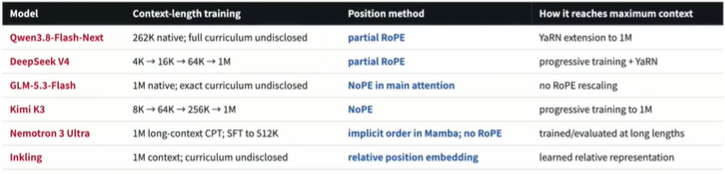
一般没有那么多足够长的,如128k个连贯tokens所组成的数据。因此会先做短上下文的预训练,再用更长的文档做继续训练,最后进行长上下文的适配
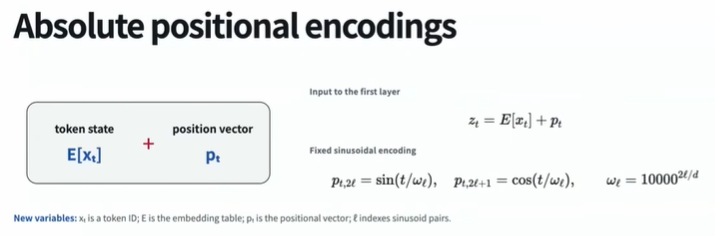
 位置编码
绝对位置编码
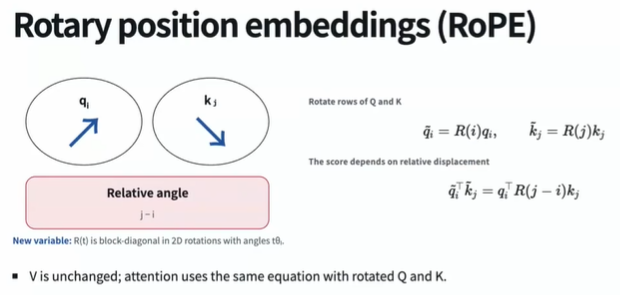
 旋转位置编码
这个思路是想要一个位置嵌入,让位置编码被完全去掉,由两个token之间的相对距离来决定。而不想让绝对位置影响两个token会不会互相注意
 无位置编码
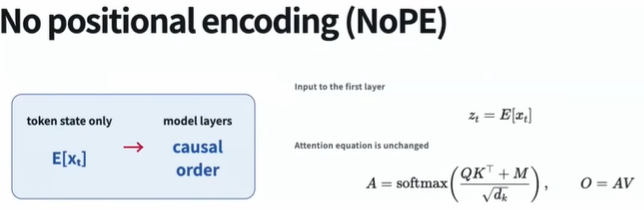
当前的transformer其实不一定要位置编码,而且即使是两个value都是相同的key,他们也是不一样的。因为在他前面,也就是他自己能够看到的token也不一样
对于自回归transformer更不需要位置编码了,一般来说,有了局部偏置之后,就不再需要位置编码了
 上下文并行
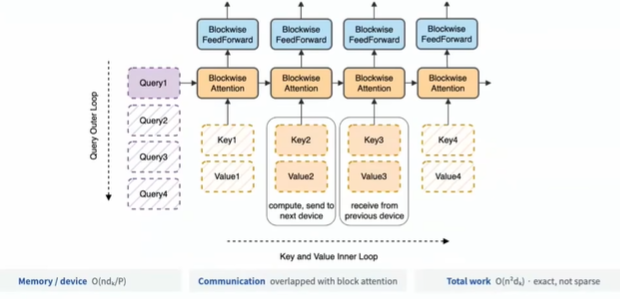
先算出一段上下文的键和值,将其发给下一个设备,那个设备会算出自己那部分的键和值,再发给下一个设备,以此类推
 prompt和kv cache
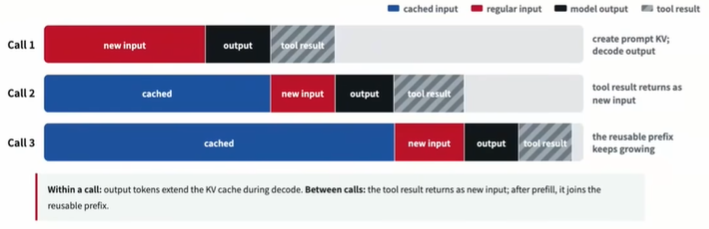
计算输入的时候,做的就是prefill;计算输出的时候,就是在做decoding。这两部分都要算KV cache,这一步在每次生成token时都会做,做完之后输出结束前每个位置的key和value,这样就可以把他们存进cache,下次就不用算了
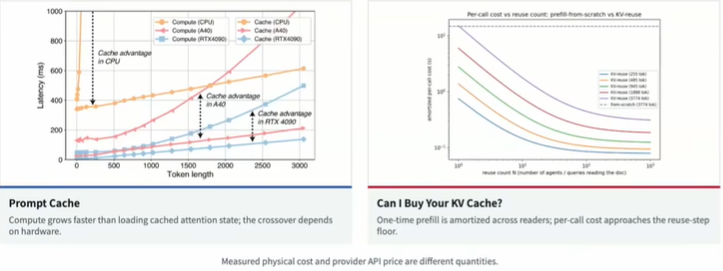
 左图横轴时不同GPU上的token长度,纵轴时使用缓存和不使用缓存各自需要的计算量。不用缓存近似二次增长,使用缓存近似线性增长
Transformer里面前馈神经网络的计算非常昂贵,如果能跳过这一步,那么会节约很多成本
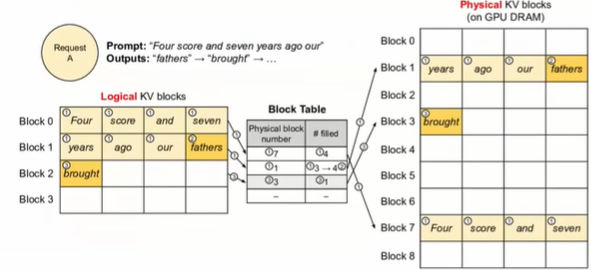
 如何管理KV-cache,一个问题是:怎么存到内存里面
有两个开源的LLM库:vllm和SGLang
vllm的机制:paged kv-cache allocation
对于一块块的物理GPU和内存,将他们组织得就像内存块或磁盘块那样,在更典型的基于CPU的机器上。
 SGLang的机制:RadixAttention prefix sharing 基数树注意力
主要是复用已经缓存过的输入,做法是构建一颗基数树,用来查找已经用过的前缀
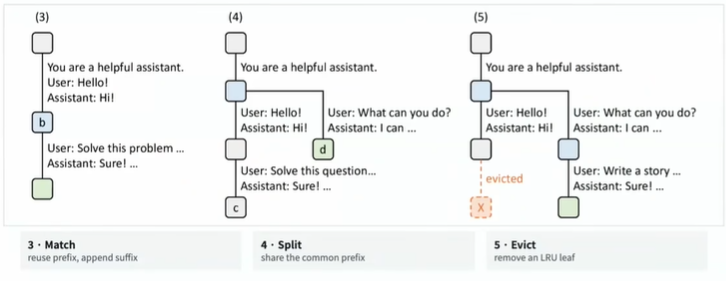 服务商不会永远保存缓存,一般来说,主流服务商保留1h左右,然后就会把对话缓存淘汰掉
context compaction
上下文压缩,一种做法是保住开头,留下较近的尾部,然后压缩较旧的部分,将这部分缓存一段摘要,这个摘要可以是结构化的。
OpenAI的一种做法是把上下文压缩成加密的东西,用户无法读取,也看不到他们是怎么压缩的。(往往是出于商业保密,不希望泄露压缩算法之类的)
压缩的次数越多,丢失的信息也越来越多,可能让agent跑偏
触发条件:一种是token阈值,也就是给token设置一个上限;另一个是服务商强制设置的token上限;还有就是手动/compact