Course Note
Lecture 1:课程概览与分词
1.模型规模所带来的影响
模型规模变大,并不是相当于小模型放大,而是连同计算瓶颈和工程直觉都会变化
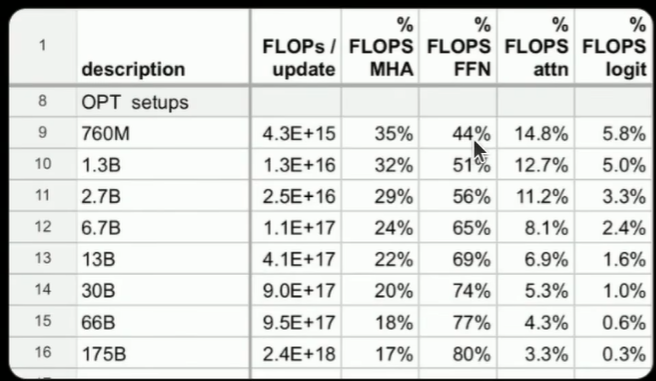 模型越大,计算越集中在FFN-MLP上,而不是attention上。
在小规模模型下行之有效的策略,在大模型上可能没有收益。
2.涌现效应
行为会随规模扩展而出现涌现现象
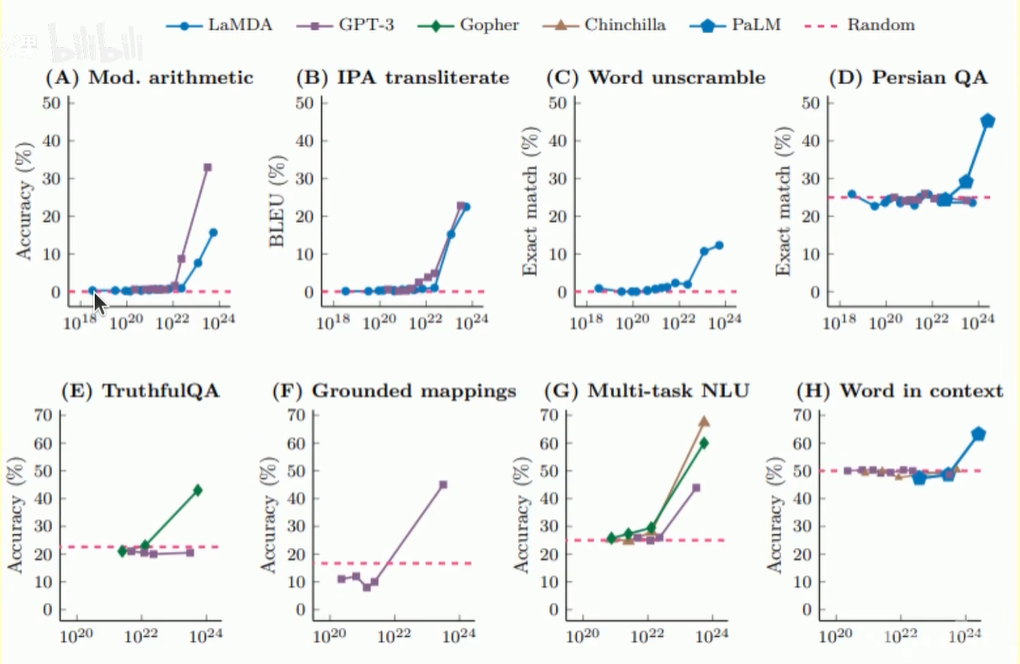
3.工程思维 很多设计都是工程经验,经由实验证明有效 accuracy=efficiency * resources 效率和准确率都很重要,要尽量最大化效率
4.课程大纲
(1)basics 1.Tokenization 本质是确定模型所操作的基本单元,将输入文本(字节)转换为token序列,相当于对文本进行分割。 常见的方法是:byte-pair encoding(BPE) 很多时候进行分词的目的是提升计算效率
2.Model architecture transformer是基础架构 Activation functions激活函数:ReLU,SwiGLU Positional encodings位置编码:sinusoidal,RoPE Normalization归一化:LayerNorm Attention注意力:full,sparse/local attention,multi-head latent attention MLP:dense,mixture of experts Shape:hidden dimension,depth,number of heads,number of experts
3.Training Loss function:multi-token prediciton Optimizer:Adam,SOAP,Muon
(2)system
1.Basics
总运算次数total_flops=6nd,n是模型参数量,d是token数量。
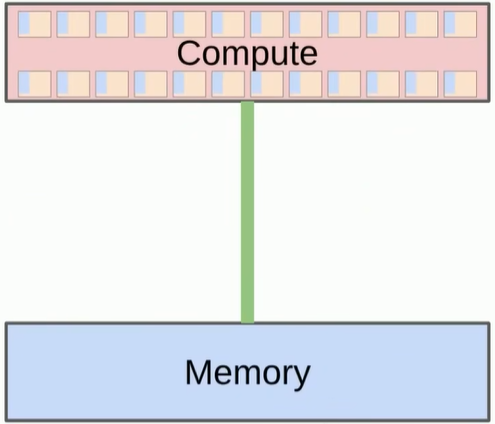
memory和compute是分开的,屋顶线分析roofline analysis能够帮我们分析一个计算到底是受限于算力还是内存。一般来说瓶颈在内存。
2.Kernels
Kernel就是跑在GPU上的函数,核心原则是安排好计算,尽量减少数据搬运,因为从内存搬运数据的成本很高。
 3.Parallelism
并行,协调多个GPU的工作,榨取GPU的性能
4.Inference
推理,目标是通过给出的prompt生成tokens
分为两个阶段:预填充和解码
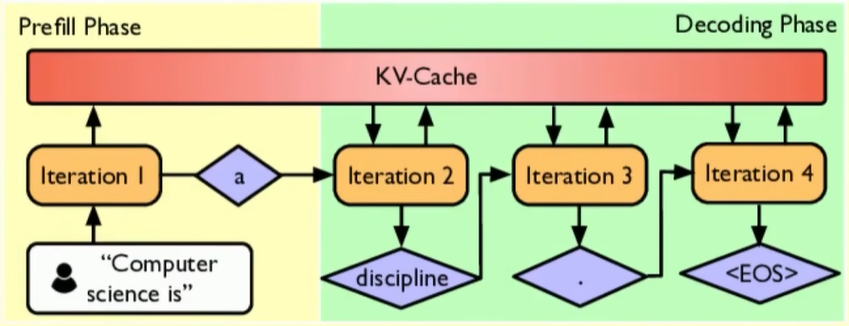
- 预填充阶段,把提示输入进去,一次性前向传播所有token,从而构建出键值对。这个过程很像训练。
- 解码阶段,逐个生成token,但很快会出现内存瓶颈。 加速推理的方式:剪枝大模型,改用更轻量的模型,进行量化,知识蒸馏,投机解码等
(3)scaling law
扩展定律
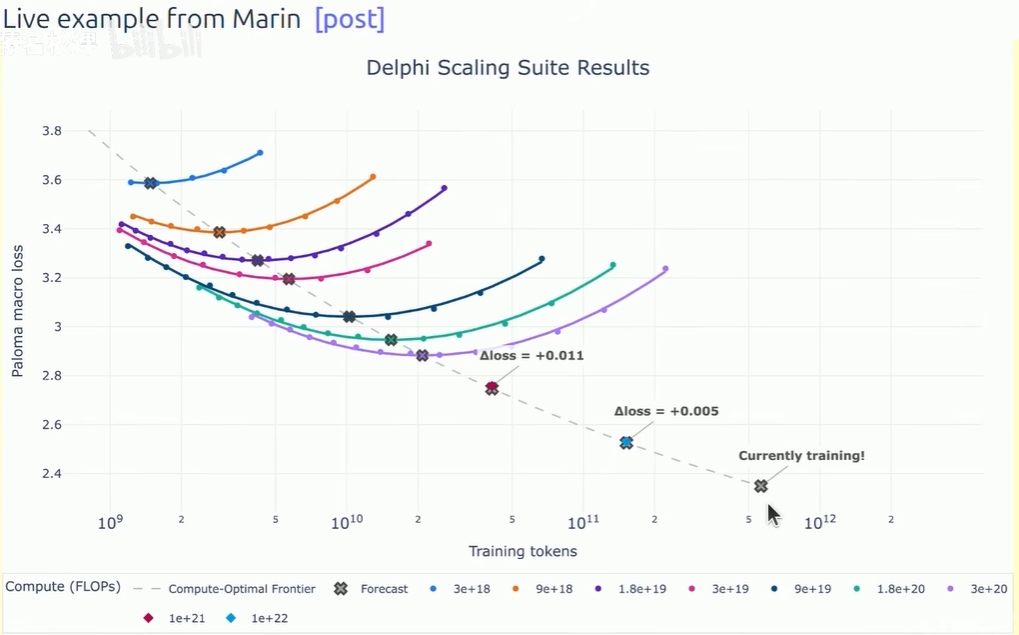
因为大模型的一次训练可能成本非常高,甚至只有一次训练机会,因此扩展配方很重要。
扩展配方是一个从计算次数到超参数的映射,通过进行小规模实验,拟合scaling law,然后预测在更大规模下会得到的结果。
可预测性的重要性至少不亚于最优性。
经验法则:参数数量的20倍,就是应该用于训练的数据量
(4)data 1.Evaluation 数据质量基本上决定了模型能有多好,数据基本上反应了对模型的期望 困惑度是一个理想的评价指标
2.Data curation
语言建模的数据集一览
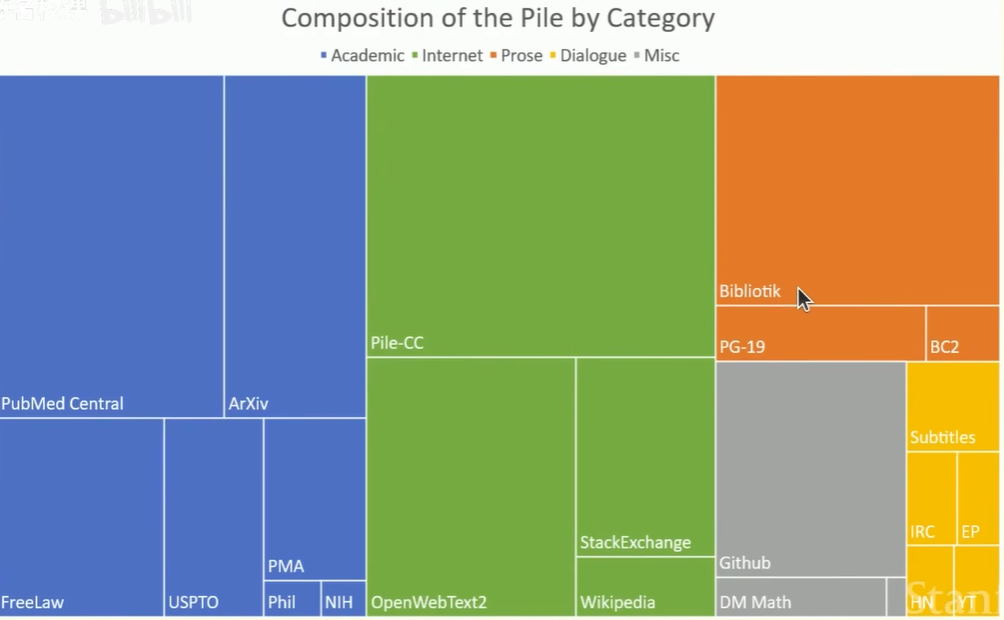
- 数据方面可能存在一些法律问题,如论文、github资源等
- 数据可能不是文本,而是pdf,html等,需要处理成文本
3.Data processing 数据类型和特点: 预训练数据,庞大而杂乱 中期训练数据,高质量,包括长下上文文本 后训练数据, supervised fine-tuning
(5)alignment 对齐 此时模型已经有初步能力,但我们仍可进一步改进,常通过一弱监督的方式。因为判断优劣总比生成内容更容易。 常用算法: PPO,DPO,GRPO等强化学习算法。缺点是强化学习算法不太稳定,而且往往对算力资源要求高。
Lecture2:Pytorch
1.tensor
tensor是基础构建,包括参数,梯度,优化器状态,数据,激活值
2.数据存储方式
FP32
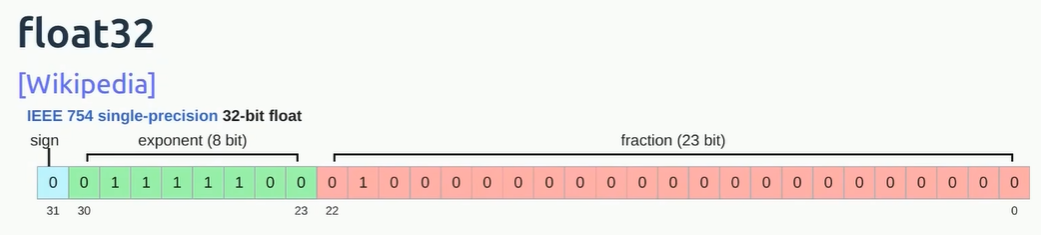 为了追求效率,通常希望减少存储量,随着精读降低,实际上节省了内存,也节省了时间。
FP16
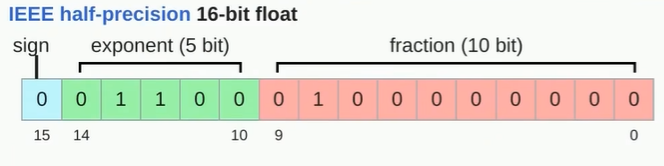 没法表示特别大或者特别小的数,如果用FP16训练的话会不稳定,会出现上溢、下溢和NaN。
BF16
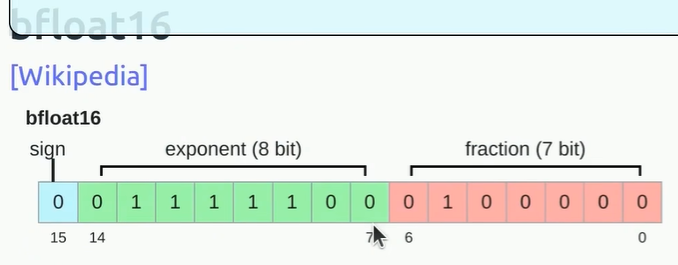 为了避免FP16的不稳定性,做法是把一部分尾数放到指数的位置。
混合精度计算
一般来说,BF16用于参数,激活值和梯度;FP32用于优化器状态
FP8
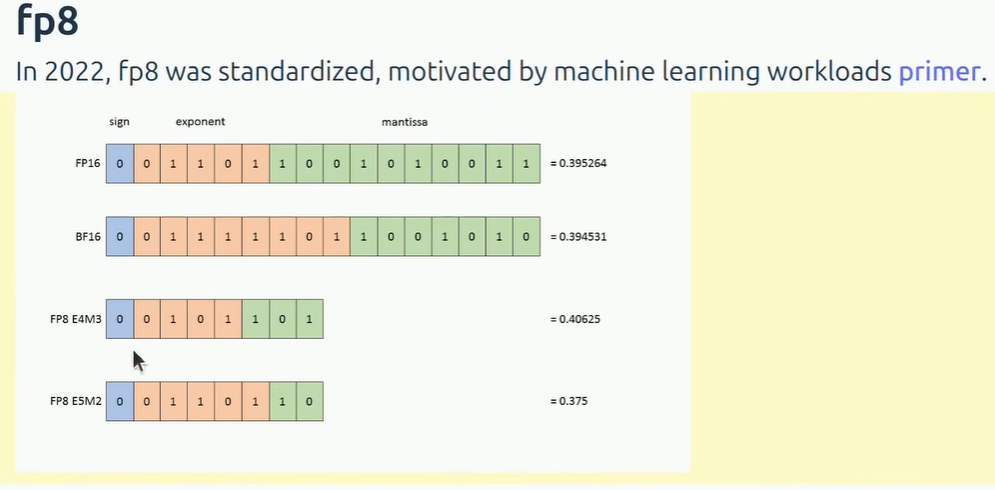 tensor默认放在CPU上,如果我们要利用GPU,那么我们需要把这些tensor移动到GPU上
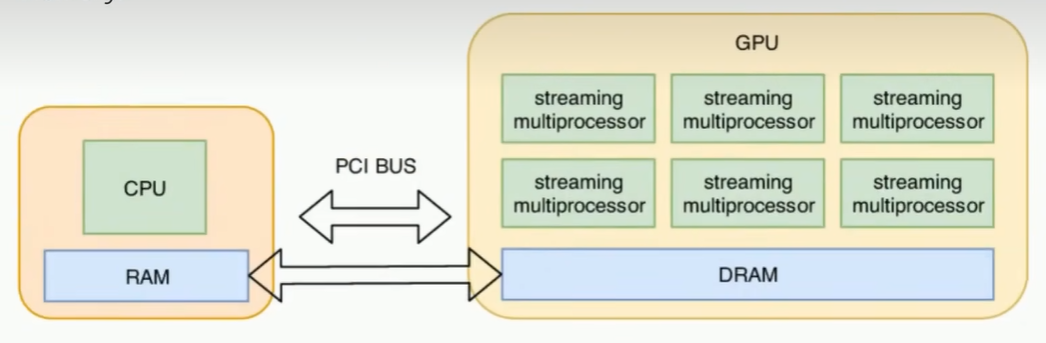
FLOPs,是浮点计算的次数,衡量计算量的指标; FLOP/s或FLOPS,是每秒浮点运算次数。 主要的计算就是加法和乘法,而矩阵乘法是最主要的运算,每秒能跑多少次浮点运算,这取决于硬件
3.MFU MFU,模型浮点数利用率,就是实际浮点计算次数/理论承诺的浮点运算次数。 一般来说,MFU≥0.5就非常好了
4.Arithmetic intensity 算数强度。衡量的是算法在处理任务时,每字节数据背后实际做了多少次计算。 如果算数强度低于加速器的临界值,就是内存受限;如果高于这个值,就是计算受限。 一般来说是显存受限的状态,因为数据搬运的代价很高。 因此我们希望提高算数强度,这样就能充分利用GPU。基本思路是,尝试在每搬运一个字节的数据时多做一些计算。方法是多做矩阵乘法和其他高强度的计算。
5.pytorch einops/einsum dot_product gradient SGD,AdaGrad,Adam 显存不仅影响存储大模型的能力,有时还影响速度,因此一般要尽量减少显存占用。 常做的是梯度累积,一般来说,批次大小要足够大,以提高稳定性,直到达到临界批次大小。激活显存会随批次大小增加。 批次大小太大的话,一般会把一个批次拆成若干个微批次,在每个微批次上计算梯度,然后把梯度累加起来。
Lecture 3 Architecture
1.标准transformer架构
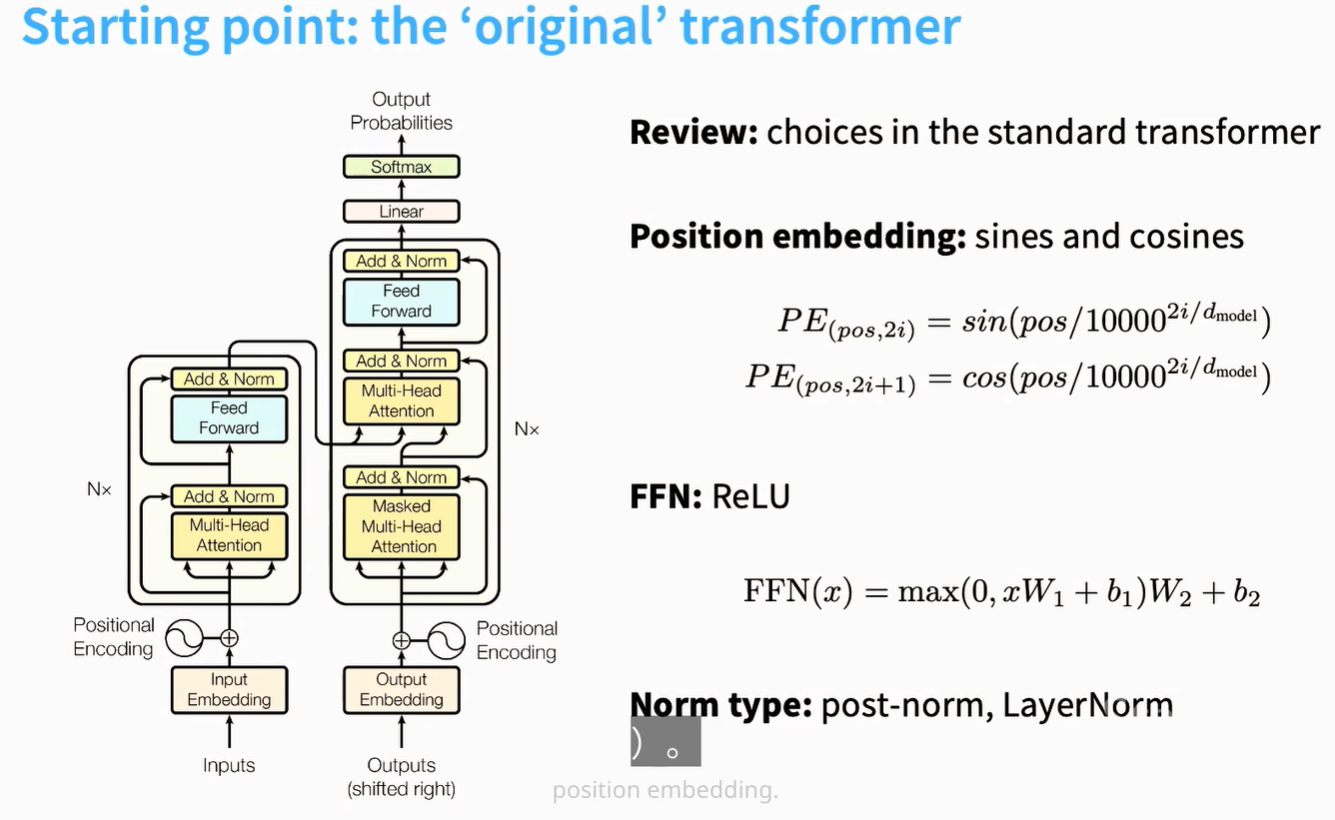 对标准架构的一种改动
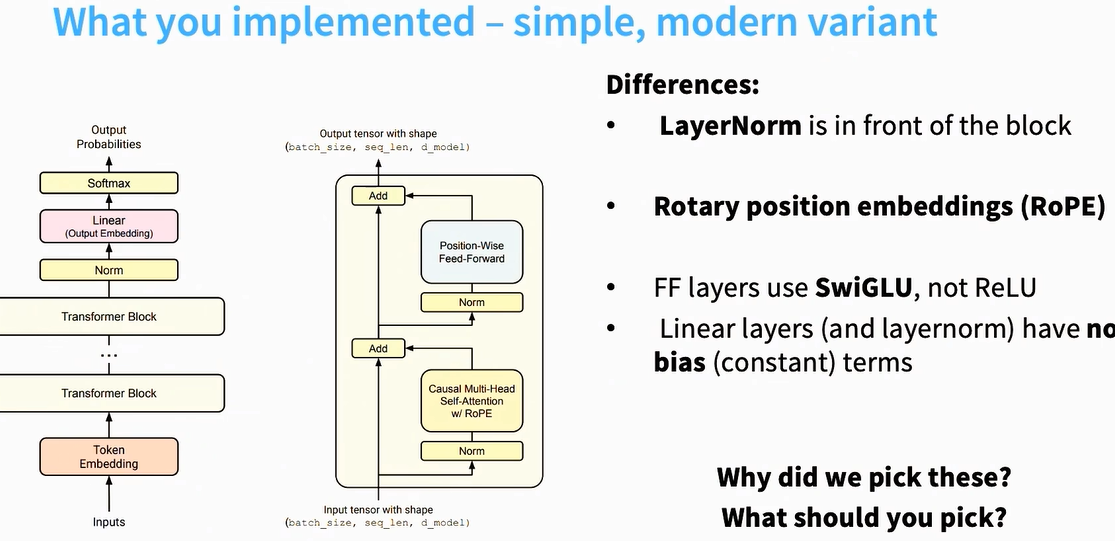 模型架构类型一览
 2.Layer norm
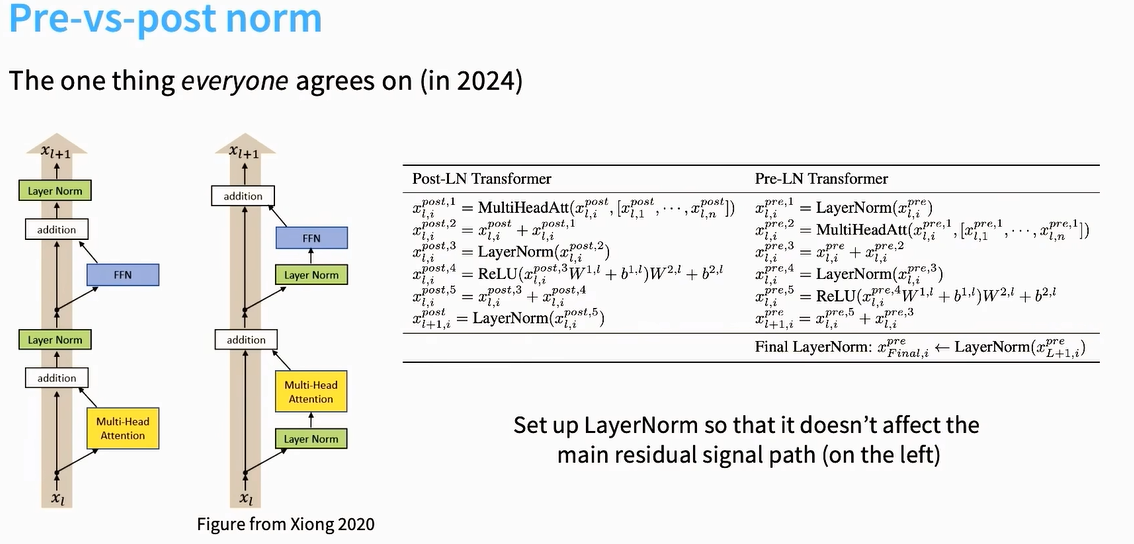
现代语言模型常把layer norm放在残差流外面,称为pre-norm,目的是保持残差流干净,具体来说就是梯度的范围不会有太大变化,而是趋于稳定。
遇到稳定性问题,可以在各处加一个layer norm,比如mha层之后,也就是用两个layer norm
RMSNorm和layer norm表现一样好,但是它能运行更快,现在通常用的都是RMSNorm
 矩阵乘法的主要计算开销在乘法运算,统计归一化的主要开销在于内存搬运
现在为了降低内存搬运开销,并从系统层面简化设计,通常会去掉偏置项bias
3.激活函数
激活函数一览:
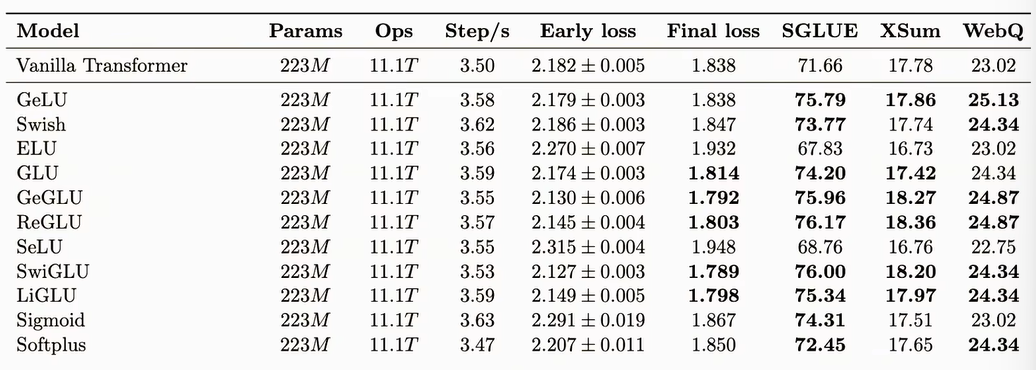 对于非线性激活函数而言,门控变体能够在几乎不增加计算机成本的前提下,带来明显的性能提升。
4.并行
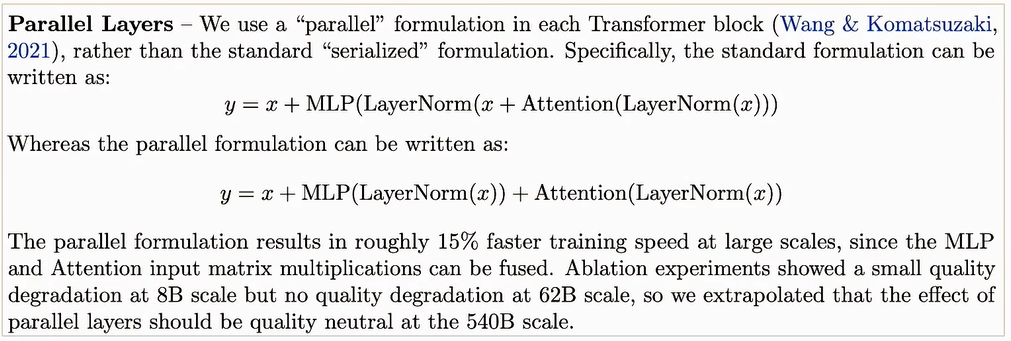
并行,不同于顺序嵌套的形式,而是把transformer中的MLP的输出和注意力的输出相加。只要实现得到,可以复用很多组件,如layer norm和矩阵乘法。这能够从架构上获得收益。
不过串行的优势已经比较好了,并行客观上降低了模型深度,对表达能力可能有害。
5.位置嵌入
常用的位置嵌入方式:
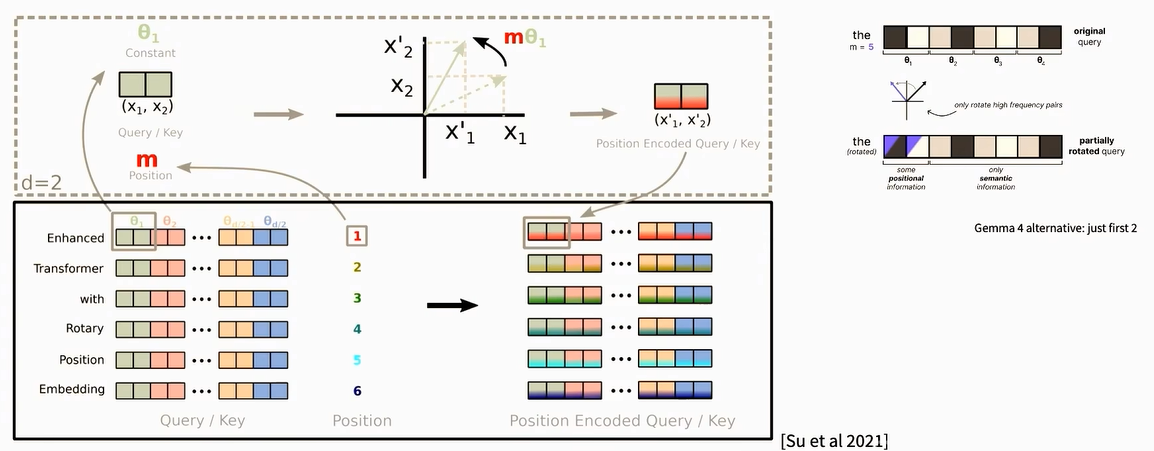
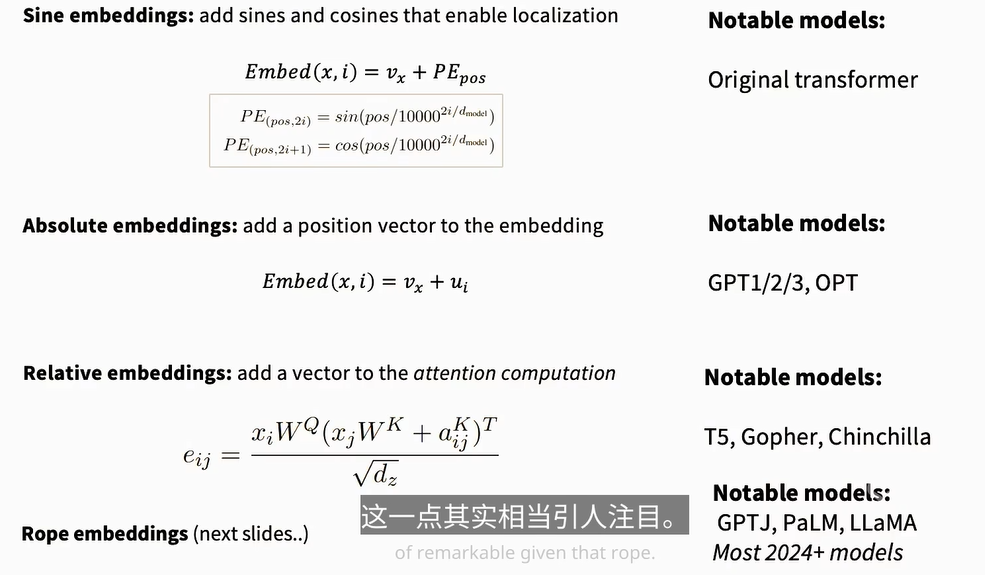 当前最常用的是RoPE enbeddding,rope是一种相对位置嵌入,我们无需在意绝对位置。
将其当作一种旋转,在注意力层而不是在底层实现,从而在每次执行注意力计算时强制实现位置不变性。
对于二维的情况,向量只有顺、逆时针两种选择,但是如果是三维甚至更高维的空间,就会有无限种情况,一种解决方法是把高维的情况看作是多个二维情况来做。
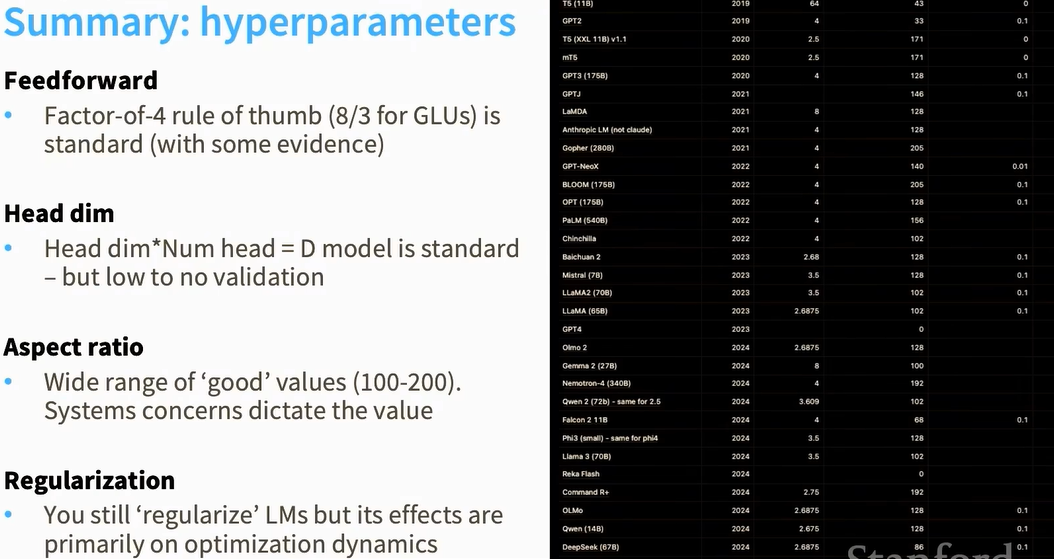
6.超参数 前馈层维度,注意力头数,词汇表大小,权重衰减,dropout,正则化,模型的深度和宽度 前馈层大小,也就是MLP中第一次矩阵乘法的输出与模型维度之间的比例,控制着MLP的丰富程度,它的大小大概是隐藏维度的4倍。这是一个经验法则 注意力头的维度大致等于模型维度除以头数 系统层面的原因促使我们选择宽架构,表达能力层面的原因促使我们选择深架构
7.dropout和regularization
当数据的量超过了可用的浮点运算次数,所以可能根本不会看到同一份数据两次。在计算受限的语言模型中,过拟合几乎从不是问题。
weight decay有时候并不是一个正则化手段,实际上在于优化器相互作用,本质上是让优化做的更好。现在不太用dropout了,因为它与优化器配合的并不好。
8.稳定性 softmax的两个因素很容易影响稳定性,一是指数运算,另一个是除法运算。即模型的输出端和对注意力进行归一化时,这两处可以看作模型的危险区。 QK norm,如果在QK相乘前加入layer norm,能够有效防止注意力退化现象 Logit soft-capping,是一种更强硬的干预测试,能够稳定注意力的输入。具体来说,是把logits,也就是直接进入softmax中的那些值,直接进行截断,让他们永远不会太大或太小。具体做法是,把注意力层的所有logits拿出来,在某个值处做soft cap。
9.Attention
组查询注意力GQA,多查询注意力MQA。
一般来说,注意力机制会有多个注意力头,MQA让这些头的Q保持一致,但共用同一组KV,这样能够提升系统效率。
但是,只公用一组KV的话,会降低模型的表达能力,在这里需要进行系统效率和表达能力的权衡。
GQA提供了一个可调的比例,保留了一部分K和V,这部分KV的数量远小于注意力头数。
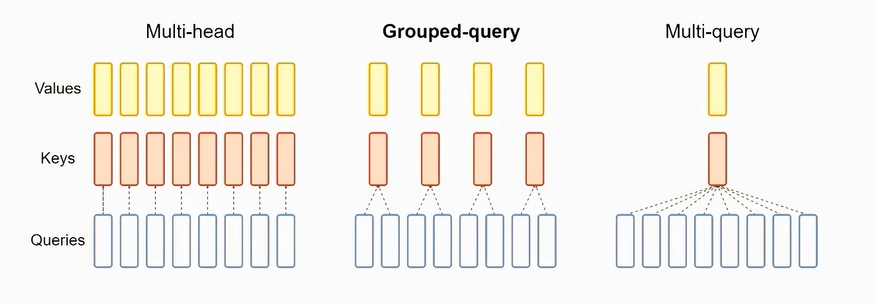 KV cache负责保存所有Q和K的点积矩阵,这样每次需要计算新内容时,就可以直接复用那些已经算好的矩阵。只需要计算新的查询-键交互,以填充矩阵的其余部分。
滑动窗口注意力,在full attention和滑动窗口attention之间交替。在full attention中,每个位置都能关注过去的所有位置,在带状矩阵式attention中,只能关注一个固定窗口内的位置。
一个例子是每四层中有一层full attention,而3个full attention之间是滑动窗口attention层,这种混合做法现在来看很有效